選別ラインのゴミを画像で見分けられるか、MATLABで試した話(条件を変えると精度はどう落ちるか)
 algo_dev_wp
こんにちは。
小澤泰生です。
ゴミを画像で見分けられないか、というご相談が昔あったので、公開データで試しに検証したらどうだろうと思って、やってみました。
聞くところによると、資源ごみの選別工場では、ベルトコンベアの上を流れてくるゴミから、人が手でペットボトルや缶を抜き取っている所が、まだあるそうです。
これをカメラとAIで見分けられないか、という話は昔からあって、海外ではロボットで拾う装置も売られています。
では実際に、公開されている画像を使って、MATLABで作ってみると、どこまでできて、どこでつまずくのか。
今回は、それを試した記録です。
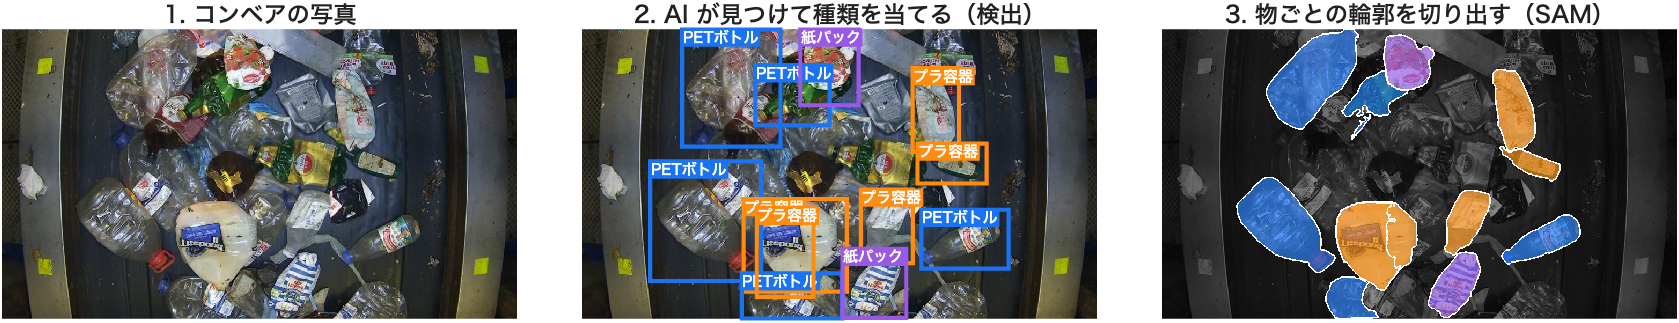
画像解析の定番の3つ、(1)「分類」(何が写っているか)、(2)「検出」(どこに何があるか)、(3)「輪郭・セグメンテーション」(物の形どおりに切り出す)を、順に試しています。
先に結論を書くと、
- 1個ずつ切り出した画像の「分類」なら、5種類で正解率88%
- ただし、正解の量を減らす、別の日の画像で試す、暗くする、ぼかす、と条件によっては76〜79%まで落ちる(強くぼかすと65%)
- コンベアの上から「見つける(検出)」のは、ずっと難しい
- 見つけた枠をSAMに渡すと、物ごとの輪郭まで切り出せる(正解の輪郭との重なりが0.59→0.69に上がる)
- 落ち方は種類によって違い、数の少ない種類(びん・缶)から落ちる
でした。
「精度98%」のような数字は、白い背景に1個だけ置いた写真なら出ます。でも、それは現場の数字ではありません。今回は、下がった数字のほうを、そのまま載せます。
何を解く問題か
ごみの選別には、大きく2つの向きがあります。
- 拾い出し:混ざって流れてくるごみの中から、資源になる物を見つけて、種類ごとの箱に移す(例:缶・びん・ペットボトルが混ざった中から、ペットボトルを拾う)
- 取り除き:ほぼ1種類だけが流れる線から、混ざった異物を抜いて、純度を上げる(例:紙だけを残したい線から、プラスチックや金属を抜く)
今回解くのは、前者の「拾い出し」の手前の部分です。
混ざって流れてくる中から、資源になる物が「どこにあって」「何なのか」を、画像で当てます。人やロボットが拾って振り分けるには、まずこれが分からないといけません。
5種類にまとめたのは、振り分け先(日本の分別の箱)に合わせるためです。
ちなみに、缶は磁石(鉄)や渦電流(アルミ)でも分けられるので、画像で見分ける価値が大きいのは、ペットボトルとそれ以外のプラスチック容器の見分けや、異物の取り除きのほうだと考えています。
使ったデータ:選別工場のコンベアの画像
使ったのは、WaRP(Waste Recycling Plant)という公開データです。
資源ごみの選別工場のコンベアを真上から撮った画像で、物が重なったり、潰れたり、暗かったりと、現場そのままの画像です。
元は28種類に分かれていますが、日本の分別に合わせて、5種類にまとめました。
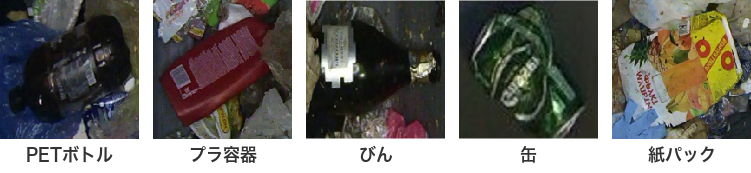
- PETボトル(透明・色付き・潰れたものなど14種類をまとめた)
- プラ容器(乳製品の白いボトル、洗剤のボトル、ポリタンクなど)
- びん
- 缶
- 紙パック
数はPETボトルが6割で、びんは5%と、かなり偏っています。現場のごみの割合そのままなので、これも現実的です。
それから、データを調べていて、気づいたことが2つありました。
- 学習用と試験用に、まったく同じ画像が9枚入っていた(学習用から外しました)
- 試験用の画像の半分以上が、学習用のどれかと30秒以内に撮られていた
2つ目は、同じ日・同じ照明・同じカメラの画像で試していることになるので、そのままだと、精度は甘めに出ます。これは後で、「別の日の画像で試す」で確かめました。
(1)1個ずつの分類:正解率88%
まず、人が付けた枠で1個ずつ切り出した画像を、5種類に分けます。
ResNet-18という、画像の分類でよく使われる小さめのAIを出発点にして、7,871枚で学習し直しました(転移学習)。ノートPCのGPU(RTX 3050・メモリ4GB)で、学習は6分弱です。
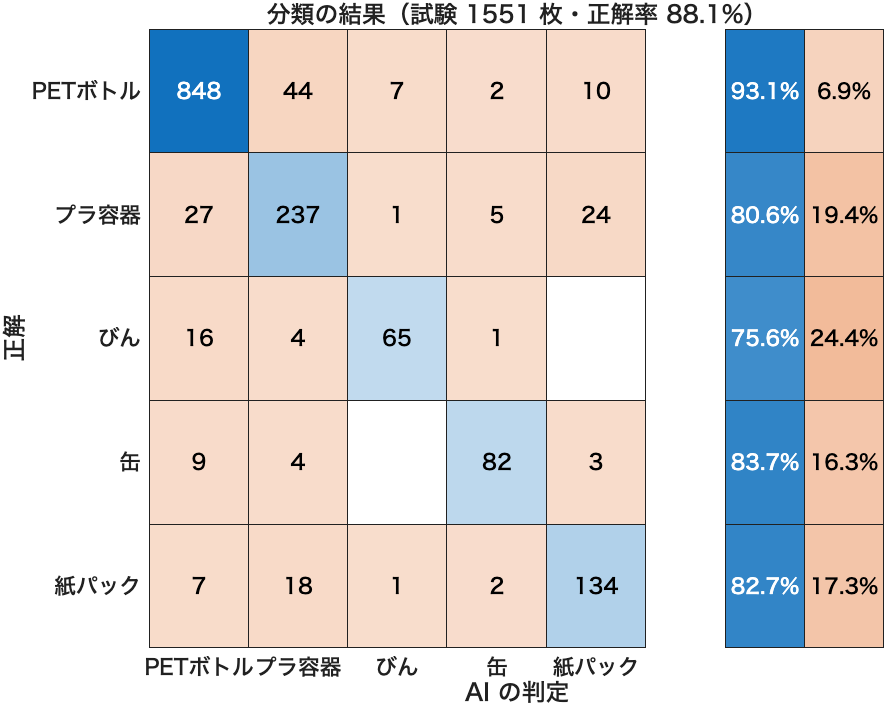
結果は、試験用の1,551枚で、正解率88.1%でした。
見分けた例を、種類ごとに並べるとこんな感じです。
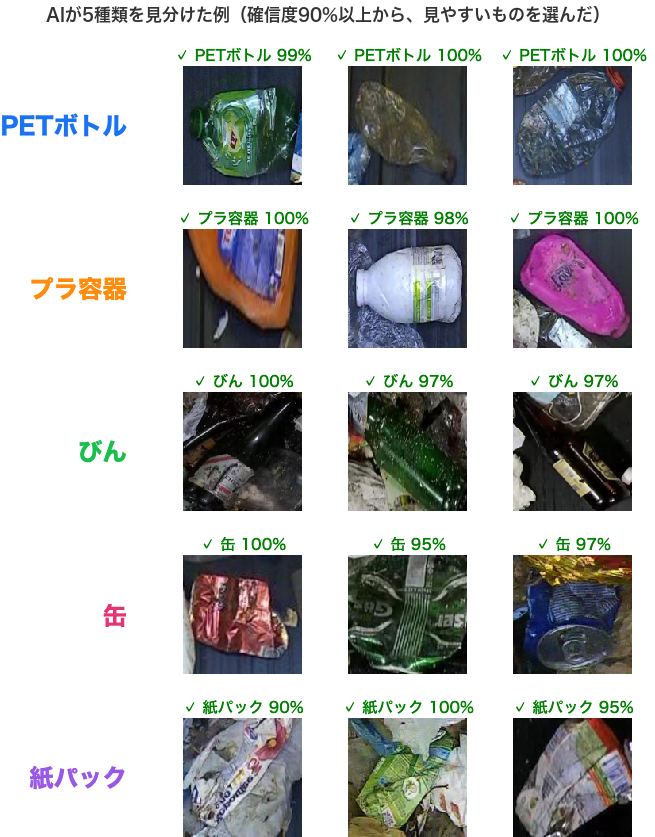
間違えた例も並べてみます。
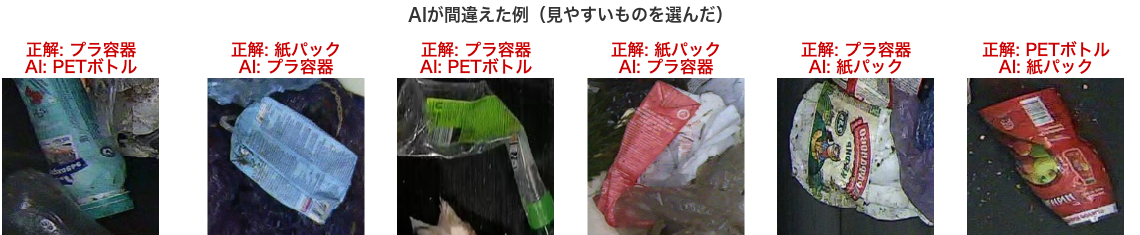
間違え方を見ると、どれも「そうだよね」というものです。
- 潰れたペットボトル → プラ容器(形が崩れると、ボトルらしさが消える)
- 緑や茶色のペットボトル ↔ びん(色が同じで、透け方しか手がかりがない)
- 乳製品の白いボトル ↔ 牛乳の紙パック(白地に印刷、で見た目が近い)
AIが画像のどこを見て判断したかを、色で重ねて見ることもできます(Grad-CAM)。
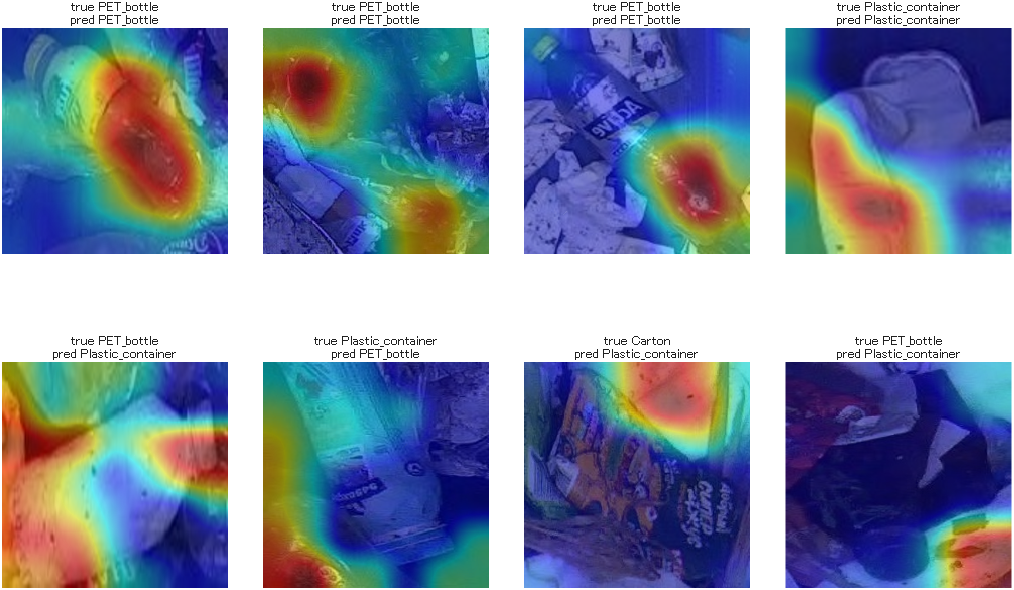
外れた例では、切り出した画像に写り込んだ「隣の物」を見ていることがありました。1個だけ置いた写真と、コンベアの上の写真の違いが、ここに出ます。
条件を変えると、どう落ちるか
ここからが本題です。条件を変えて、正解率がどう落ちるかを、2つの向きから測りました。
- 学習に使う画像を変える(正解の量・撮った日)
- 学習はそのままで、試験の画像だけを悪くする(暗さ・ぼけ・解像度)
前者は「正解を付ける手間をどこまで減らせるか」、後者は「本番のカメラや照明が悪かったらどうなるか」を見ています。
学習に使う画像を変える
正解付きの画像の数を減らしたり、ある日の画像を学習から外したりして、学習し直しました。
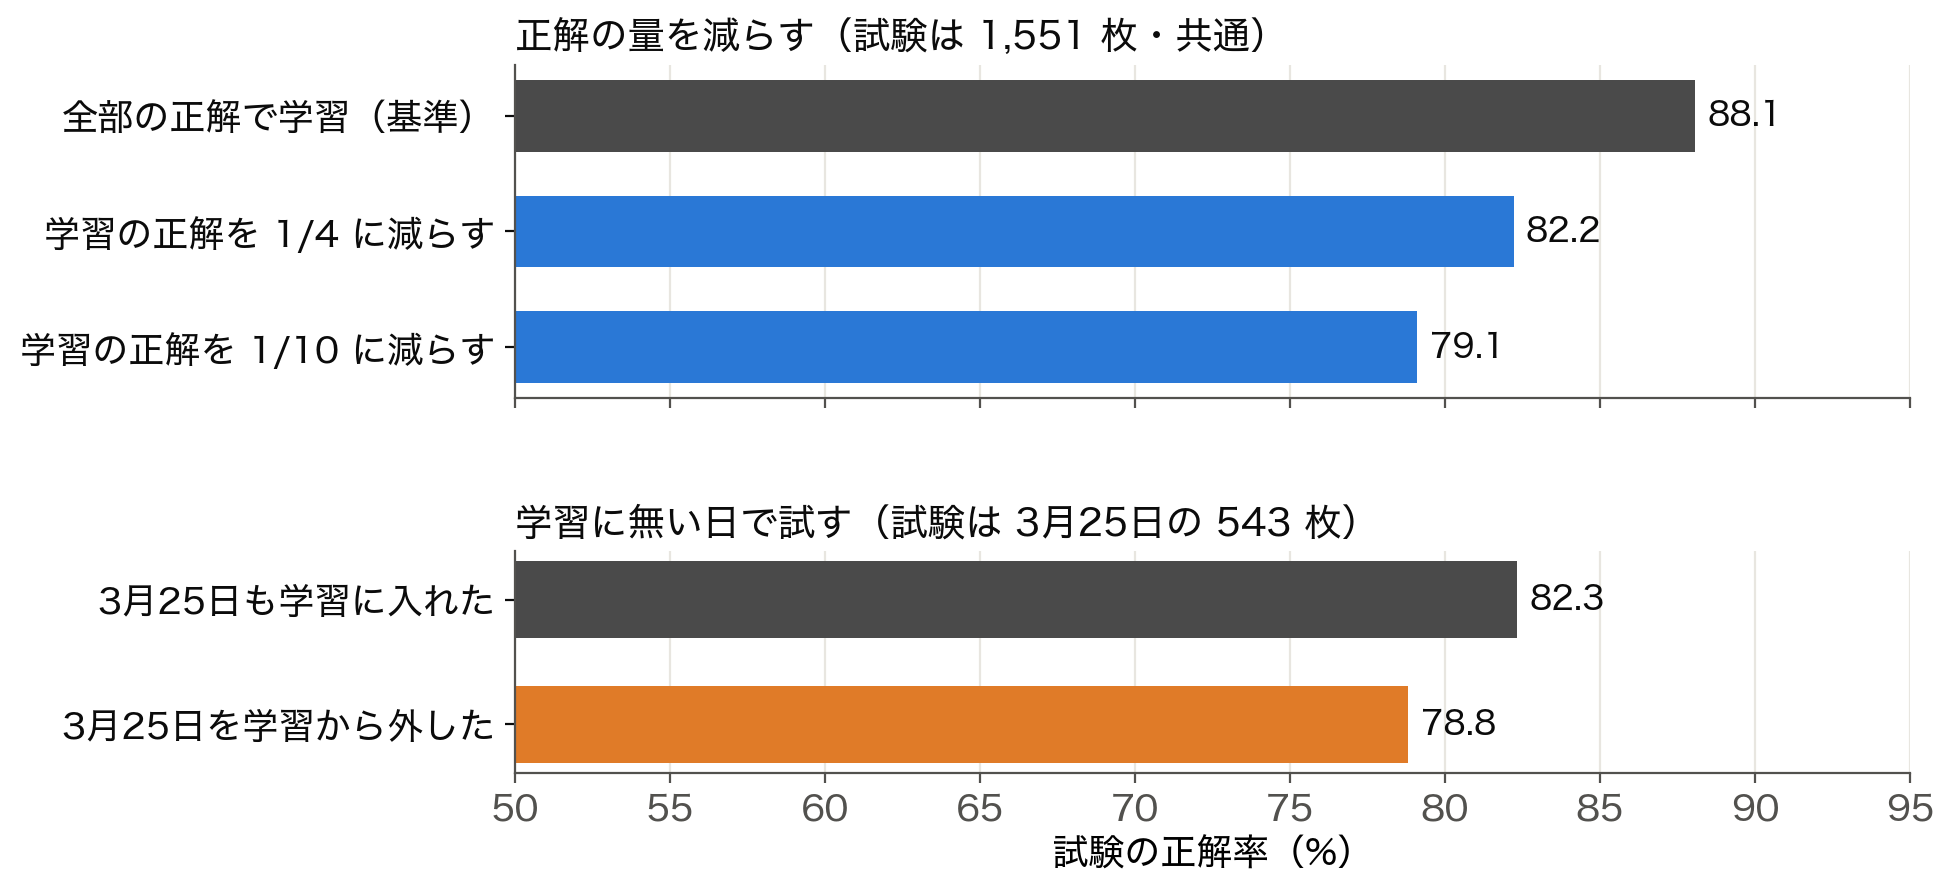
- 学習に使う正解付きの画像を1/4に減らすと82.2%、1/10に減らすと79.1%(全部使うと88.1%)
- 学習に使っていない日(3月25日)の画像で試すと78.8%(その日も学習に入れたときは82.3%)
全体の正解率は、ゆるやかに落ちます。ただ、正解を1/10にすると、びんと缶の当たり具合(F1)は0.5〜0.6まで下がりました。数の少ない種類から、先に崩れます。
試験の画像だけを悪くする
こちらは学習はし直さず、試験用の画像だけを加工しています。加工は、こんな感じです。
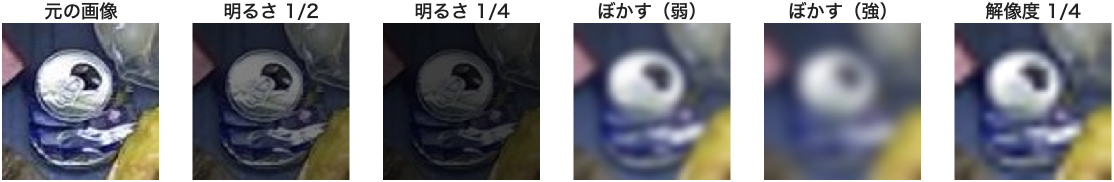
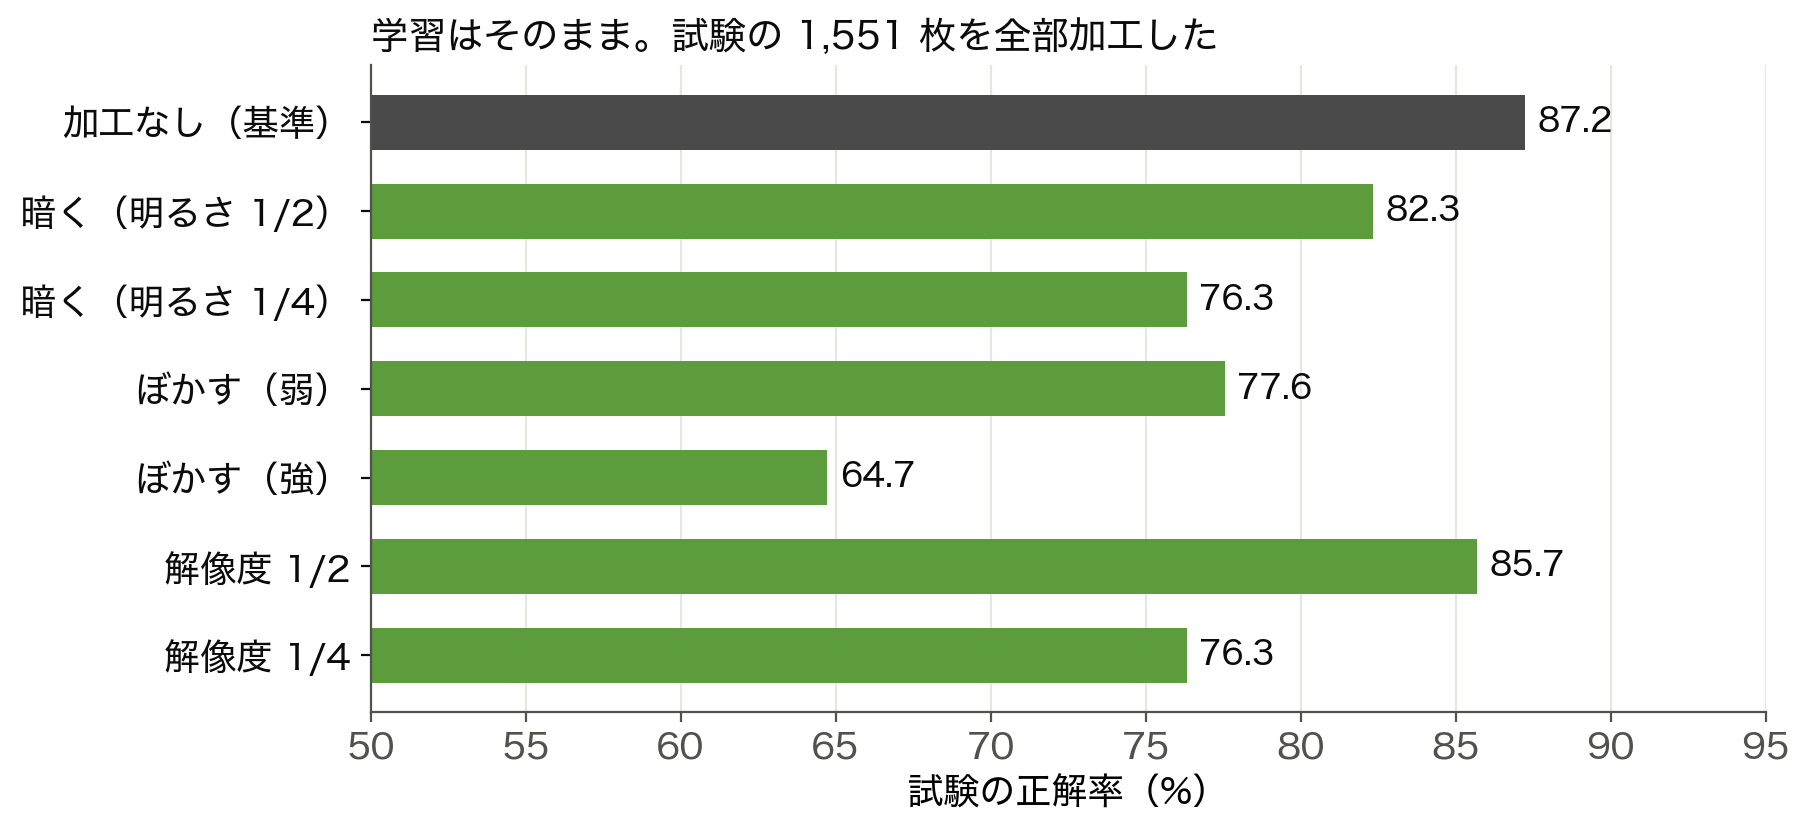
- 試験の画像を暗く(明るさ1/4)すると76.3%、強くぼかすと64.7%
- 解像度は、1/2ならほとんど落ちない(85.7%)
(基準の「加工なし」が87.2%で、上の88.1%と少し違うのは、評価のときの画像の縮め方が違うためです。)
全体の数字だけ見ると、そこそこ持ちこたえているように見えます。ところが、種類ごとに分けると、話が変わります。
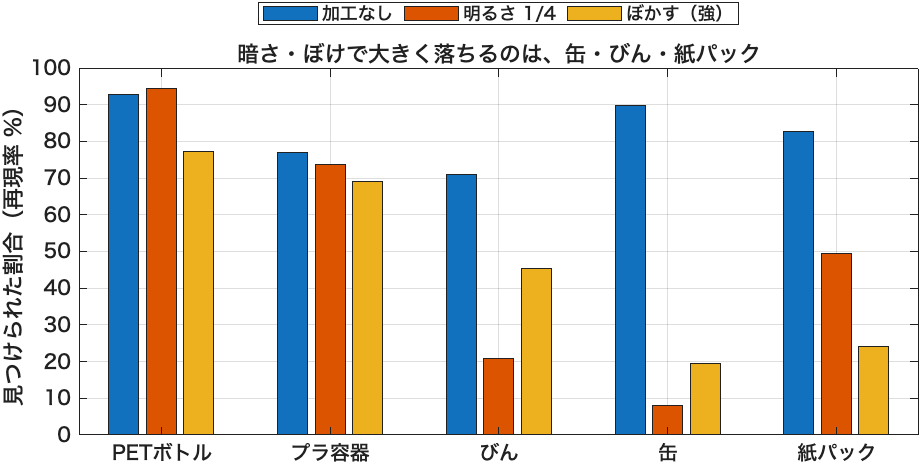
缶は、暗くすると、見つけられた割合が90%から8%に落ちました。びんも71%から21%です。金属の光り方や、ガラスの透け方という手がかりが、暗いと消えるのだと思います。
一方で、PETボトルはほとんど落ちません(むしろ上がる)。AIは迷うと、数の多いPETボトルと答えるようになるからです。全体の正解率だけ見ていると、これに気づけません。
現場向けに言い換えると、
- カメラの画素数より、照明とぶれ(シャッター速度)を整えるほうが効く
- 「全体で何%」ではなく、種類ごとの数字で判断する
- 学習に使った日とは別の日の画像で、必ず確かめる
ということになります。
(2)検出:コンベアの上から見つける
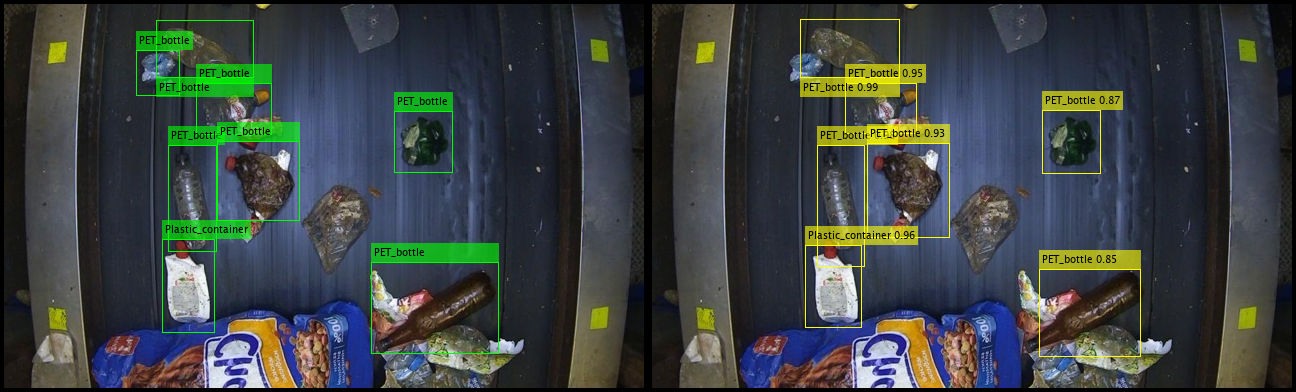
最後に、切り出す前のコンベアの画像から、5種類の物の場所と種類を一度に当てる「検出」を作りました。場所は、物を囲む長方形の枠(外枠。バウンディングボックスと呼びます)で答えます。
YOLOv4-tinyという軽い検出器を出発点に、2,199枚で学習し直しています。ノートPC 2台で、合わせて約36分の学習です。
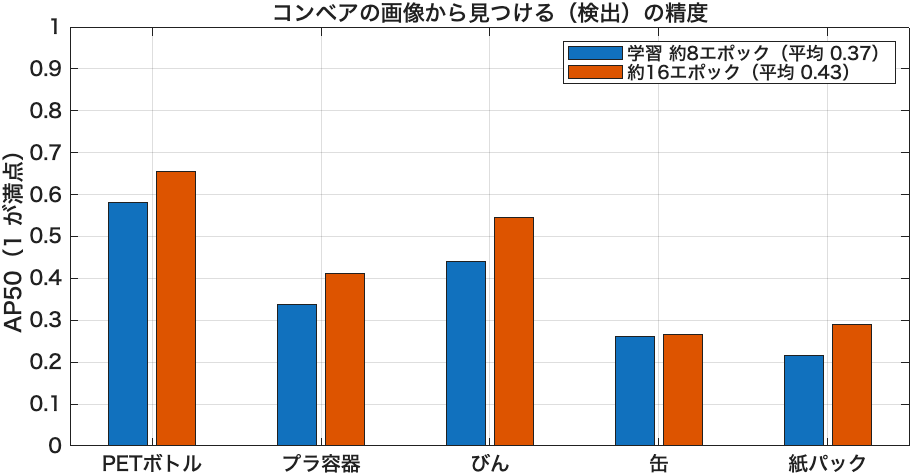
精度の目安のAP50(枠が半分以上重なれば正解、1が満点)は、平均0.43でした。PETボトルは0.66、缶は0.27です。
1個ずつの分類が88%だったのに比べると、ずいぶん低く見えますが、「どこにあるか」も当てる必要があり、重なりや隠れが効いてくるためです。物がまばらな場面ではよく見つけますが、山積みの場面では見落としが多くなります。
ちなみに、学習を80エポック(約2時間半)まで延ばしてみましたが、試験の精度は25エポックあたり(AP50 0.40)で頭打ちになり、先の短い学習の0.43を超えませんでした。
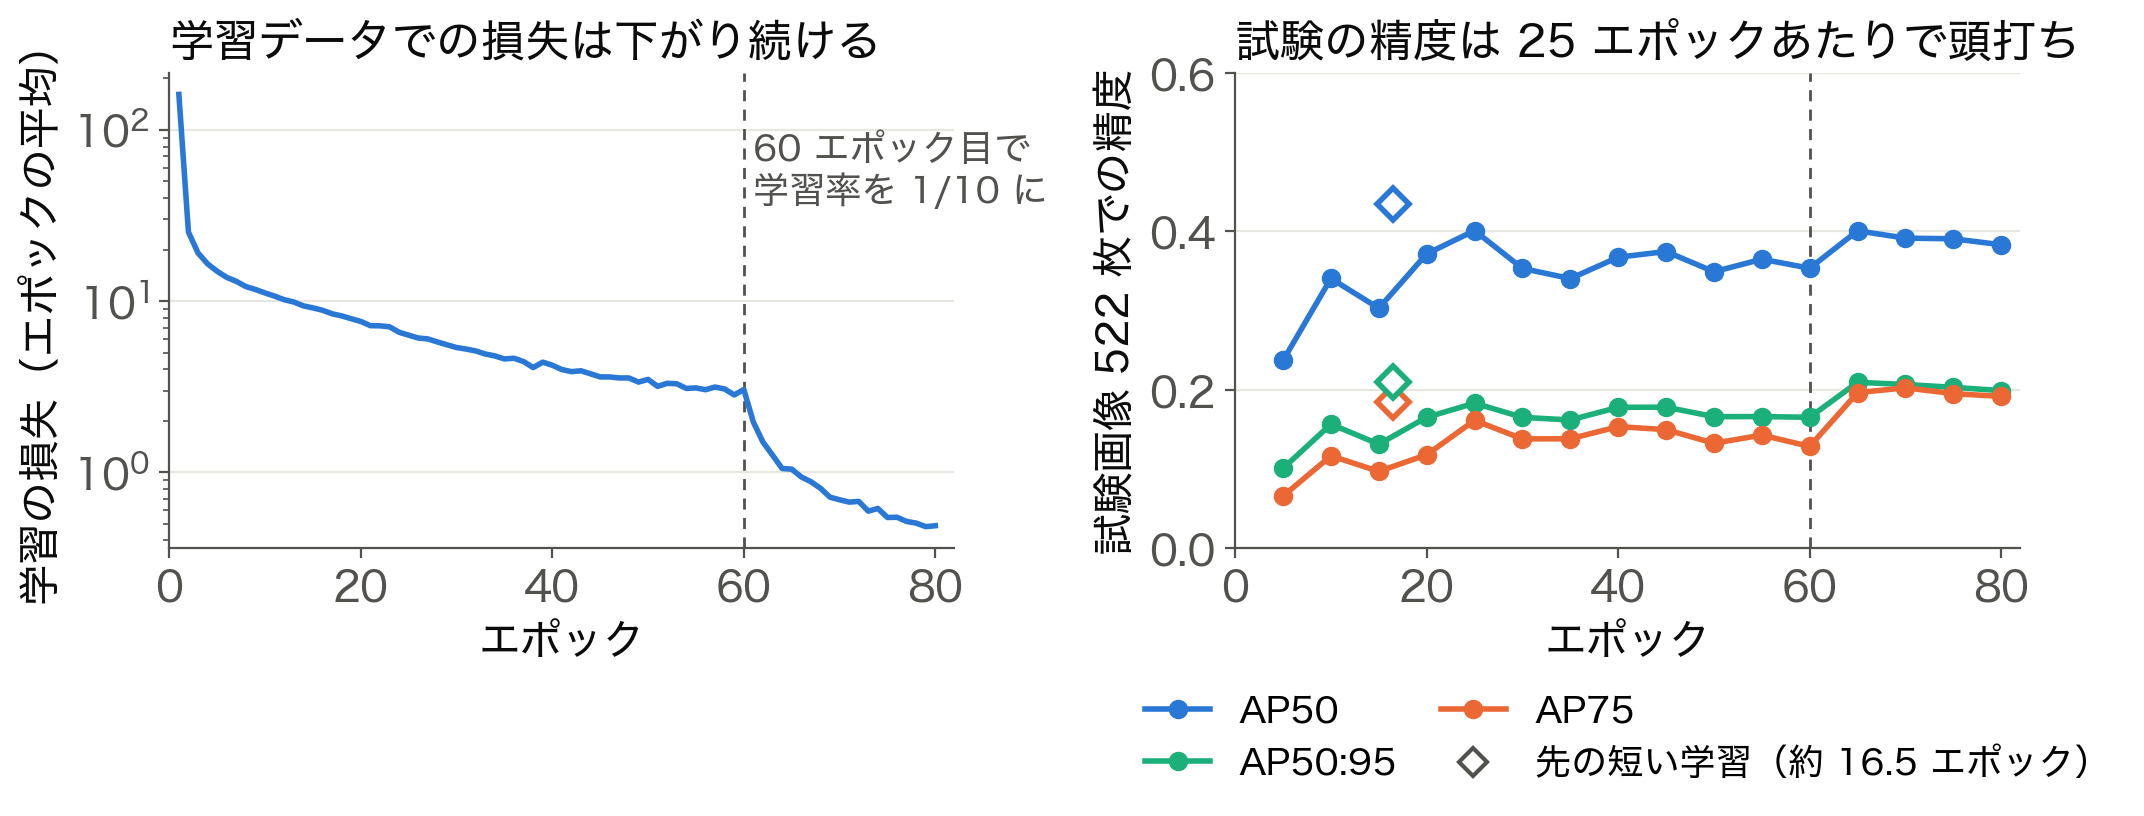
学習データでの損失は下がり続けるのに、試験の精度は上がらない。学習データに合わせすぎ(過学習)の形です。効いたのは、60エポック目で学習率を下げたところで、枠の重なりを厳しく見る精度(AP75)が0.13から0.20に上がりました。
精度を上げるには、回数を増やすより、水増しを強くする・解像度を上げる・大きい検出器にする方が見込みがある、と考えています(ここはまだ試していません)。
(3)輪郭・セグメンテーション(枠から輪郭へ)
検出の枠は、物を囲む長方形(外枠)なので、物の形とは合いません。面積の割合を出したり、ロボットがつかむ位置を決めたりするには、物の輪郭が欲しくなります。
そこで、SAM(Segment Anything Model)を使ってみました。画像と「この枠の中の物」を渡すと、学習なしでその物の輪郭を返してくれるAIです。種類は分からないので、種類は検出器が、輪郭はSAMが受け持ちます。
WaRPには、輪郭の正解が付いた画像が112枚あるので、「枠をそのまま輪郭とみなす」場合と、「SAMの輪郭」を比べました。
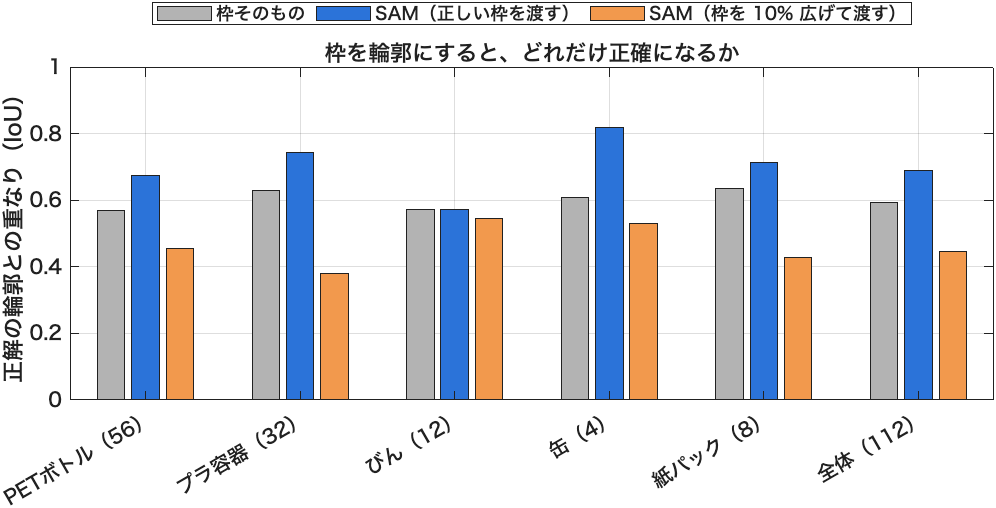
正解の輪郭との重なり(IoU、1が満点)は、
- 枠そのまま:0.59
- SAMの輪郭:0.69(112枚中89枚で枠より良くなった)
- 枠を10%広げてからSAMに渡す:0.45
でした。
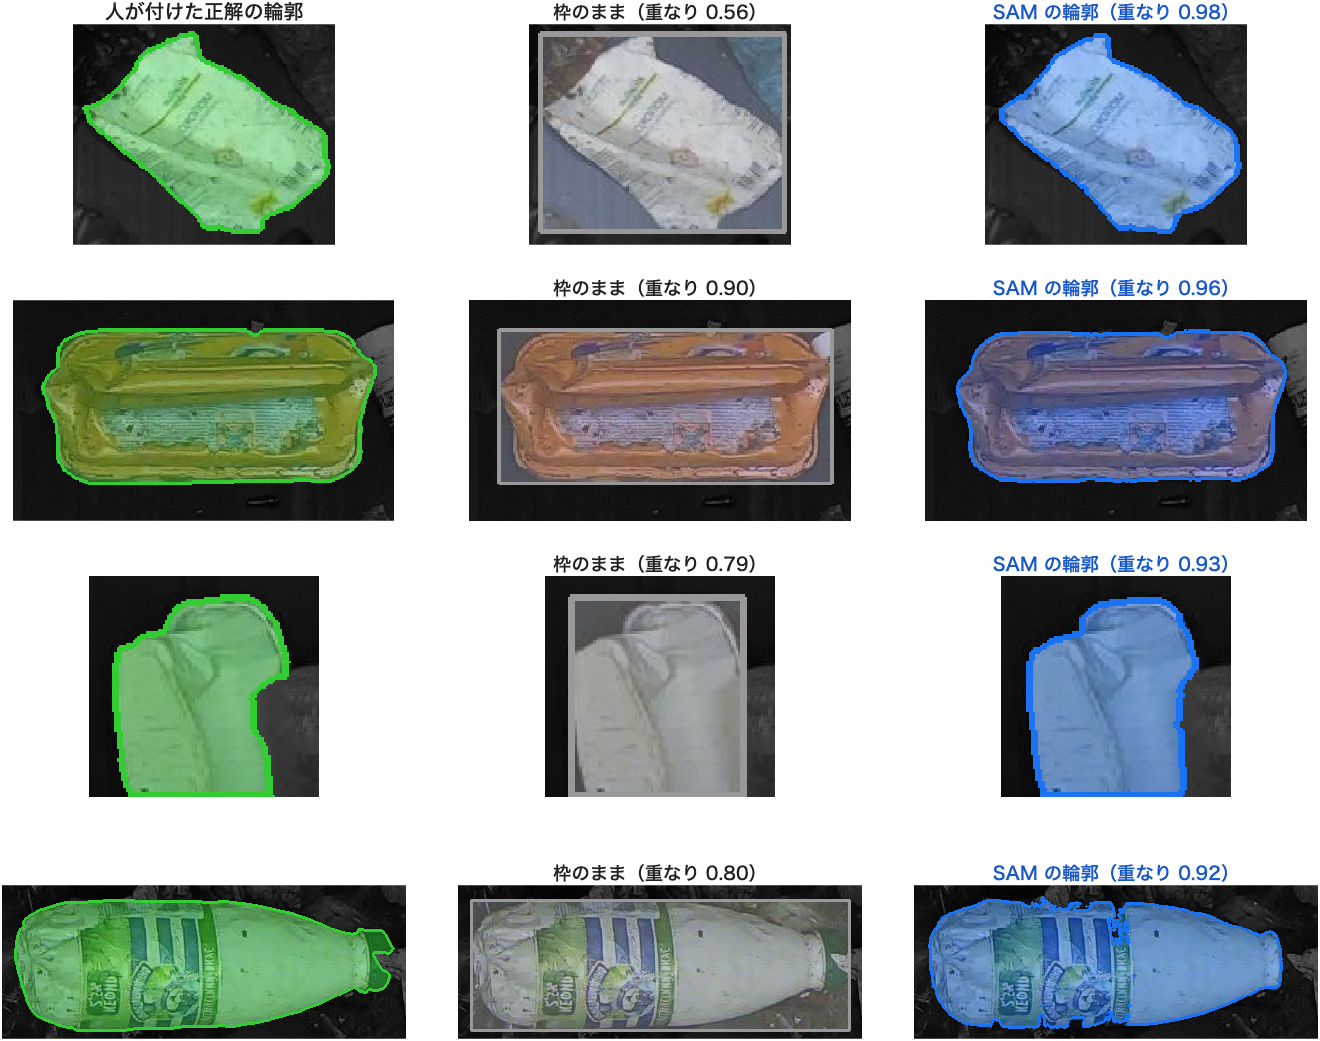
SAMはうまくいけば、ボトルの形にきれいに沿います。面白いのは、枠を少し広げてから渡すと、隣の袋まで輪郭に含めてしまうことです。SAMの出来は渡す枠の正確さで決まるので、検出を良くすれば、輪郭も一緒に良くなります。
それから、びんだけはSAMでも良くなりませんでした(0.57→0.57)。透明や暗い色のガラスは、背景との境目が見えにくいのだと思います。
コンベアの画像で、検出の枠をSAMで輪郭にすると、物の形がくっきり浮かび上がります。
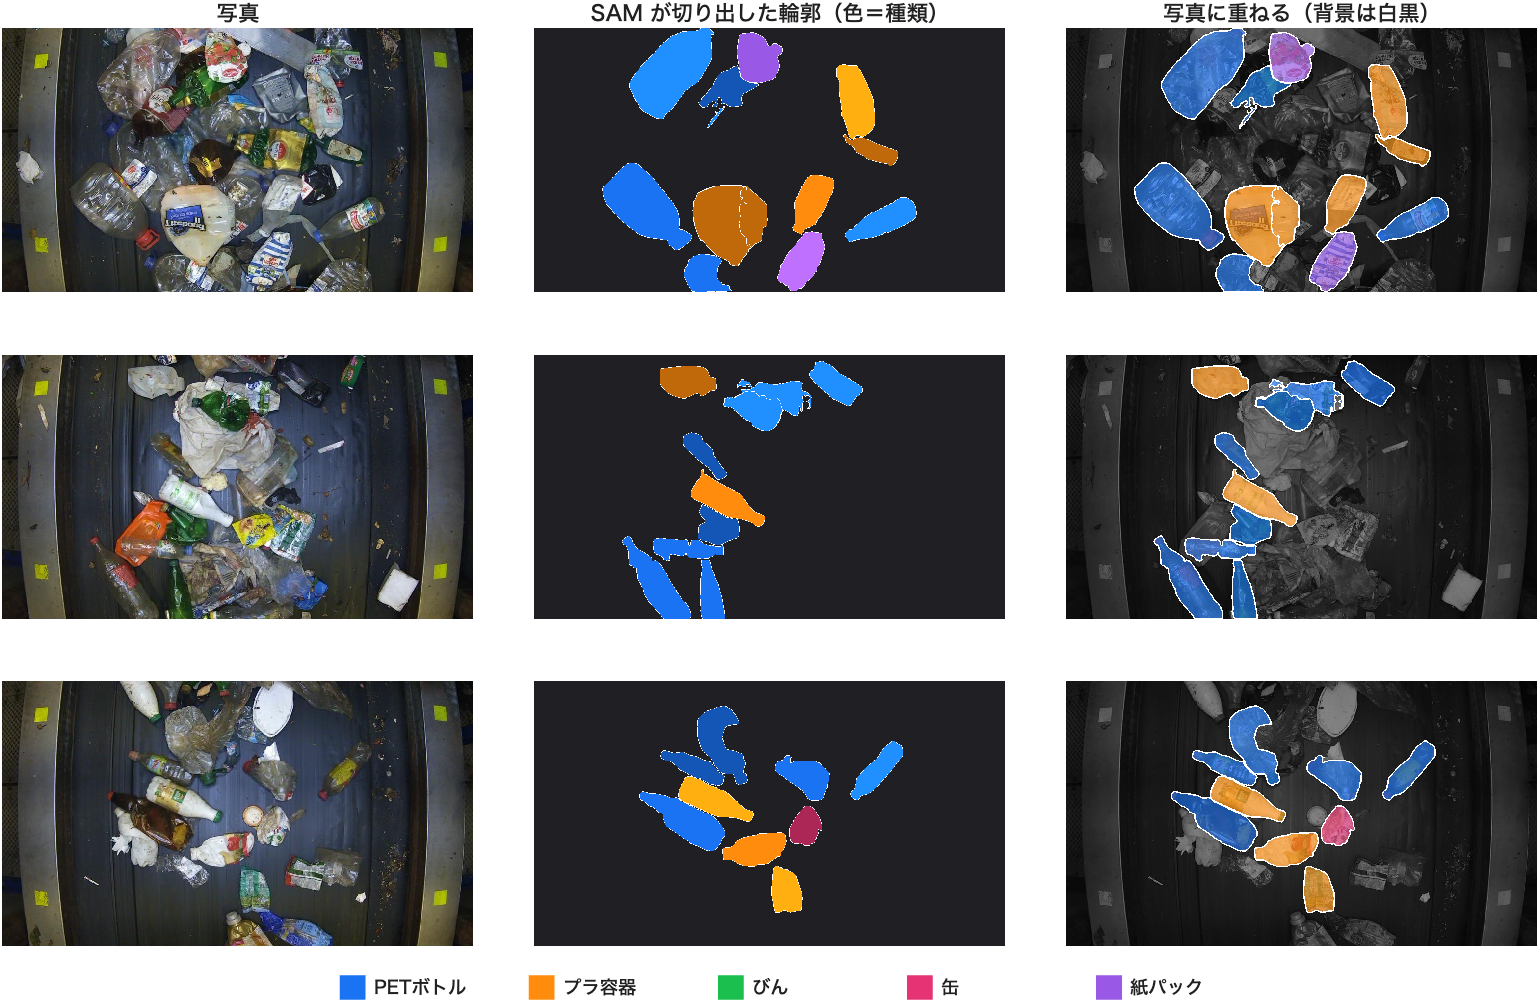
いろいろな場面で並べると、こんな感じです。
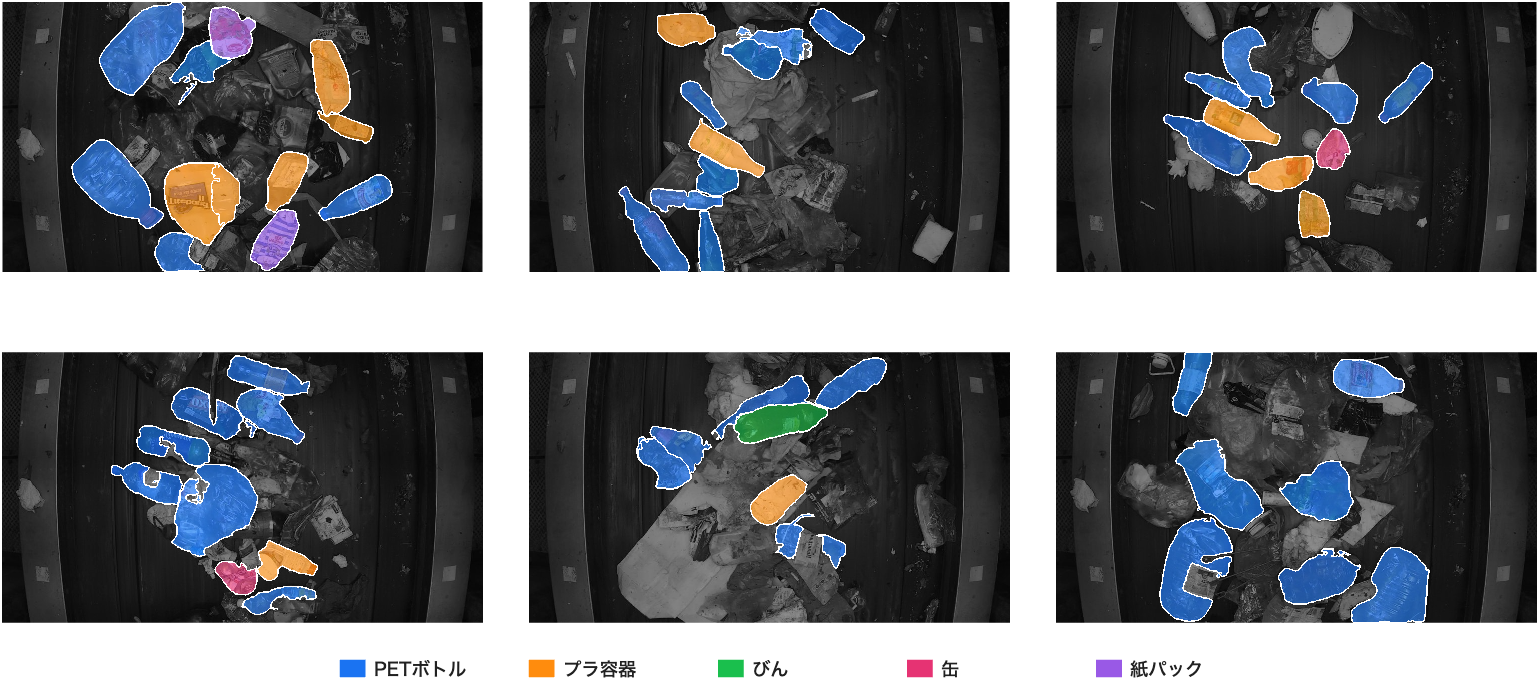
今回はノートPCのGPUで動かしましたが、それでも1枚あたり数秒で輪郭が出ました。SAM 2など、より速く動くように改良された新しいモデルも出てきているので、今後は、さらに手軽に、速く使えるようになっていくと思います。
画像だけでは分からないこと
今回はふつうのカメラ(RGB)の画像なので、見た目で分かることしか分かりません。
- プラスチックの材質(PETかPPか、など)は、近赤外のカメラ(分光)が要る
- 黒いプラスチックは、近赤外でも難しい
- 金属の種類や、電池が混ざっているかは、X線などが要る
「どのセンサーで、何を見分けたいか」から決めるのが、本当は先です。
次に試すこと
- 日本の家庭ごみ(ペットボトル・缶・びん・紙パック)を自分で撮った写真で試す
- 検出の精度を上げる(水増し・解像度・検出器の大きさを変える)
- 正解付きの画像が無いときに、学習なしで分類できるAIがどこまで使えるかを比べる
現場の写真が数百枚あれば、その現場での落ち方も、同じ手順で測れます。
報告書(PDF)
この記事の内容を、報告書の形(32ページ)にまとめたものです。方針・学習の条件・種類ごとの数字など、記事では省いた細かいところも載せています。
使ったデータ・ソフトウェア
- データ:WaRP(Waste Recycling Plant Dataset)。Kaggleで CC0(パブリックドメイン)として公開されているもの
- 論文:Yudin, D. et al., "Hierarchical waste detection with weakly supervised segmentation in images from recycling plants", SSRN 4183424
- MATLAB R2025b(Deep Learning Toolbox、Computer Vision Toolbox、Image Processing Toolbox)
- 学習済みのAI:ResNet-18、YOLOv4-tiny(COCO で学習済み)。どちらも MathWorks 提供のもの
- PC:ノートPC(GPU は RTX 3050 Laptop 4GB と RTX 4050 Laptop 6GB)
この記事の数字は、技術紹介のための試作で測ったもので、条件ごとに1回ずつ学習した値です。実際の現場での精度を保証するものではありません。
一緒に作るなら
選別や検査の画像で、「AIで見分けられるか」を試したい方は、まず、手元の現場の写真で、何が言えるかを確かめるところから始めます。
うまくいくところだけでなく、どの条件で落ちるかも含めて、ソースコードと説明スライドでお渡しします。

画像処理・深層学習の開発全般は、こちらにまとめています。
https://algo-dev.com/services/imgdev/
https://algo-dev.com/services/deep_learning/
近況報告メルマガのご案内
このブログの記事は、代表の小澤がお送りしている近況報告メルマガから転載しています。
生成AIを使った開発の話や、MATLAB・画像処理の話などを、ゆるい頻度でお届けしています。新しい号をメールで受け取りたい方は、こちらからご登録ください。